ツールを呼ぶかを Jev に判定させてみた
判定そのものは速くて安い。精度は判断の種類しだいだった。
1 回の判定は約 0.3 秒。claude -p で Claude に聞くと、起動を含めて約 4 秒かかった
1 回約 0.00006 ドル (定価からの計算。多い回で 0.00013 ドル)
haiku と同じくらいで、sonnet・Opus よりはっきり低い。前の調べで足りるかを推し量る判断が苦手
何を試したか
以前、ツールを呼ぶかどうかを Jev に判断させる記事を読み、「ツールなどを Jev に判断させるには、ある程度文脈を渡さないと精度が出ないのでは」と投稿しました。
今回、社内で使っている要望ヒアリング AI で、ちょうど試せる場面がありました。この AI はお客様の話を聞き取って、要望をまとめます。返事を書く前に、システムのコードを調べるツールを呼ぶかを自分で決めています。この判断を Jev に任せたらどうなるかを、評価用の会話で擬似的に試しました。本番の会話には入れていません。題材は工場向けの業務システムですが、話の筋は、ほかの業務システムの問い合わせ窓口でも同じだと考えています。
確かめたかったのは、ツールを呼ぶ必要があるかを、Jev がどれだけ見分けられるかです。あわせて、その判定で要らない調べを省いたときに、返事が速く安くなり、質も保てるかを見ました。
在庫一覧の表に、「品名」を表示する列を追加したい、というご要望ですね。
「品名」の列は、「品番」の列のどちら側に置くのがよいですか?
- 表示するのは、各行の品番に対応する品名です。
- (略)
記録した内容は「カンバン」ページから確認・編集できます。
ご協力ありがとうございました☺️
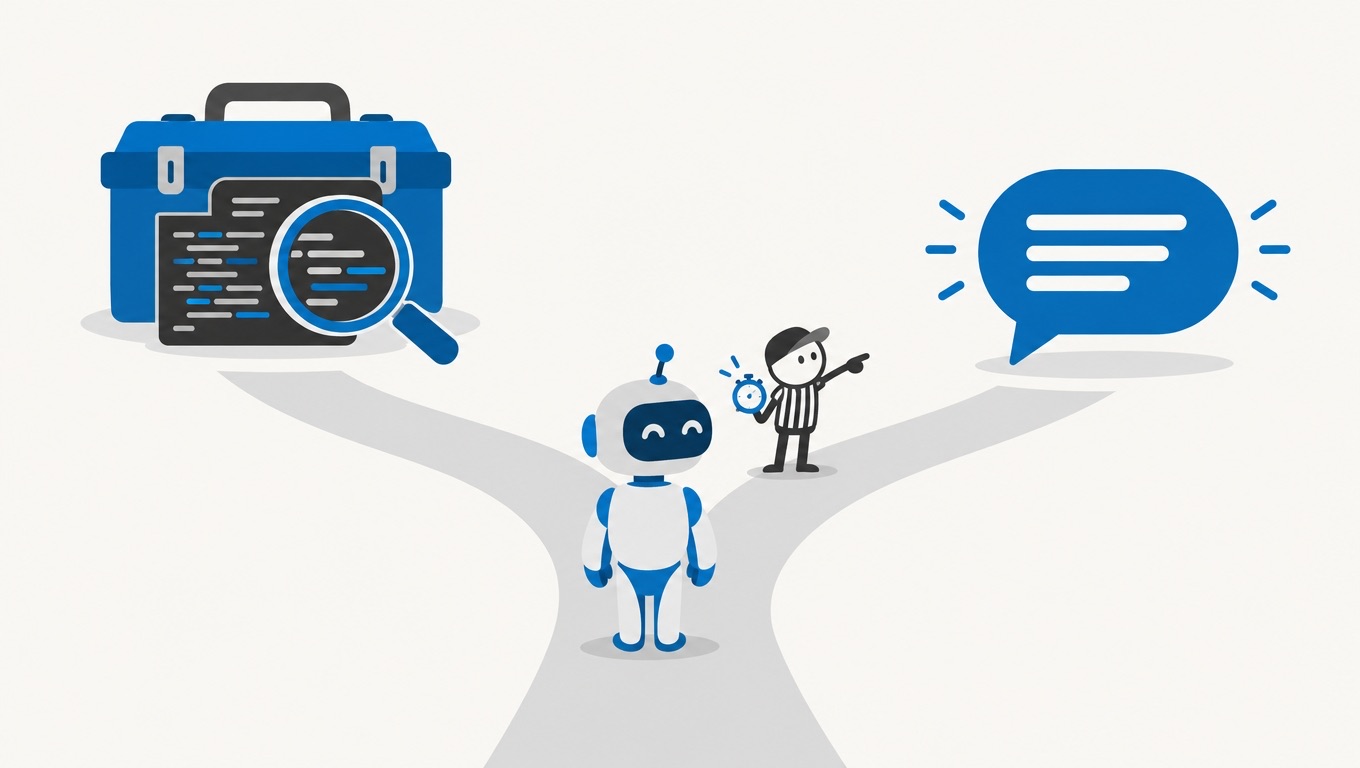
図 1 のように、返事の待ち時間の大半はコードを調べる時間です。評価の会話では、返事の時間の約 4 分の 3 を占めていました。要らない調べを省ければ、返事が速く安くなります。そこで、調べる前に「このターンで調べる必要があるか」を Jev に判定させました (図 2)。
やり方
- AI がお客様役を演じる評価用の会話から、2 ターン目以降の 181 ターンを使いました
- ターンごとに、「新しく調べる必要があったか」の正解を付けました。正解は別の AI (Claude Opus 5) が付けました。調べで新しく分かった事実が、返事に要ったかどうかを見ています
- 判定役は Jev 1.13.0・Claude Haiku 5.5・Claude Sonnet 5.5・Claude Opus 5.5 の 4 つです。4 つとも、下の同じ材料と同じ問いで聞きました。Opus は、正解を付けた Opus 5 と同じモデルの癖が入らないよう、Opus 5.5 にしました
判定役に渡したもの
ターンごとに、次の 3 つを JSON で渡しました。
- 直前の 6 つの発言 (1 つにつき 600 字まで)
- その会話で前にコードを調べた結果のうち、新しい 2 回分 (1 回につき 1,500 字まで)
- 今のお客様の発言
問いは次の 1 文です。判定役は「はい」の確率を 0 から 1 の値で返します。
社内システムの問い合わせ窓口の AI が、利用者の最新の発言 (latest_user_message) に答えようとしている。答えるために、システムのコード・設定・データの持ち方・過去の票を、これまでのコード調査 (previous_code_research) に書かれていない所まで新しく調べる必要があるか。これまでの調査と会話だけで答えられるなら no。
システムの画面の一覧や作りの説明は渡していません。システムの中身で判定役に届くのは、前の調べの結果に書かれていた分だけです。
実際に渡した材料の例 (「登録に失敗しました」のターン)
{
 "conversation_so_far": [
  {"role": "user", "content": "出荷のとこでとうろくおしたらエラーでます"},
  {"role": "assistant", "content": "ご報告ありがとうございます☺️ 「出荷」のところで登録を押すとエラーが出る、というご報告ですね。エラーが出たのは、どの画面での登録ですか?"},
  {"role": "user", "content": "📋 ダッシュボードの「事前登録」"},
  {"role": "assistant", "content": "「事前登録」の登録でエラーが出る、というご報告ですね。エラーが出たとき、画面にはどんなメッセージが表示されましたか?"}
 ],
 "previous_code_research": [
  "(1 回目の調べ) 登録のボタンがある画面の一覧と、それぞれの URL",
  "(2 回目の調べ・1,500 字で打ち切り) 事前登録のボタンと入力欄の場所、保存の処理、必須の項目、エラーになる条件 (必須の項目が空・数や日付の形が違う・対象が見つからない・すでに使われた登録を直そうとした)"
 ],
 "latest_user_message": "赤い字で登録に失敗しましたってでます"
}
前の調べの結果には社内のコードの場所が書かれているので、中身を伏せて要約しています。会話の改行は省いています。
Jev の値と時間・費用は、要望ヒアリング AI に組み込んだ判定と同じ問いの文と、同じ字数の上限で測りました。組み込んだ判定の文には「正しく答えようとしている」と「正しく」の 1 語が入っています。Jev に上の文で聞き直しても、精度はほぼ同じ (0.625) でした。前の調べの結果は評価の記録から取り出したため、道具の記録の文字 (先頭の content=' など) と、改行を表す \n が付いたまま渡しました。組み込んだ判定は、答えの文だけを渡します。1,500 字の枠に入った中身の字数は、答えの文だけを渡した場合の 99.7% でした。
結果
要る・要らないを見分ける精度は、AUC という物差しで比べました。0.5 が当てずっぽう、1.0 が完璧です。
| 判定役 | 精度 (AUC) | 1 回の時間 | 1 回の費用 |
|---|---|---|---|
| Jev 1.13.0 | 0.62 | 約 0.3 秒 | 約 0.00006 ドル |
| Claude Haiku 5.5 | 0.65 | 約 3.9 秒 | 約 0.0008 ドル |
| Claude Sonnet 5.5 | 0.76 | 約 3.7 秒 | 約 0.011 ドル |
| Claude Opus 5.5 | 0.78 | 約 3.6 秒 | 約 0.018 ドル |
Claude の時間は、手元から CLI (claude -p) を起動する時間を含みます。API を直に呼べばもっと短くなる見込みです (測っていません)。Claude の費用は、haiku と sonnet は公開の料金表から出した目安、Opus は CLI が返した値で、CLI の起動の分も含みます。Jev の費用は、記録した 277 回の入力のトークン数に定価 (入力 100 万トークンで 0.042 ドル、出力は無料) を掛けた中央の値です。会話が長いほど上がり、多い回は 0.00013 ドルでした。
どの発言で当たり、どの発言で外れたか
Jev は発言ごとに「新しく調べる必要がある」確率を 0 から 1 の値で返します。0 に近いほど、調べなくても答えられるという見立てです。値がしきい値より低ければ調べを省く、という使い方をします。
評価の会話から 3 つの場面を選び、お客様の発言ごとに Jev の見立てと実際を並べました。その発言に返事を書くときに本当にコードを調べ直す必要があったかを、「実際」の欄に書きました。「やり方」で書いたとおり、AI が後から会話を読み直して付けたものです。
- Jev の見立て
- 0.23 = 調べなくてよさそう
- ほかのモデル
- haiku 0.04・sonnet 0.03・Opus 0.04
- 実際
- 調べは要らなかったまとめた内容を認めただけで、返事は記録した知らせだけだった
- 結果
- 当たり (どのモデルも当たり)
- Jev の見立て
- 0.16 = 調べなくてよさそう
- ほかのモデル
- haiku 0.05・sonnet 0.03・Opus 0.05
- 実際
- 調べが要った前の返事は切り替えの場所を「画面左上」と大まかに書いていた。コードを調べて正しい場所が分かり、案内し直した
- 結果
- 外れ (どのモデルも外れ)
- Jev の見立て
- 0.44 = どちらとも言えない
- ほかのモデル
- haiku 0.30・sonnet 0.65・Opus 0.80
- 実際
- 調べが要った渡した前の調べには、入力の誤りで出るエラーは書いてあったが、この文が出る場合は書いていなかった。コードでは、権限が足りないときや想定外のエラーのときに出る文だった
- 結果
- 迷った (sonnet と Opus は見分けた)
お客様の発言は評価で AI が演じたものです。吹き出しの文は、分かりやすい言葉に直して短くまとめています。判定役が見たのは元の会話です。会話の最初の発言はどれも、Jev の値が 0.69 以上でした。最初はまだ何も調べていないので、高く出るのが自然です。
「この内容で記録する」のような確かめるだけの発言は、4 つの判定役がどれも低い値を出して当たりました。
「まだ切り替えていない」は、Opus も含めてどれも外しました。前の返事の案内が大まかだったと気づくには、本当の画面の作りを知っている必要があります。渡した材料には、それが入っていませんでした。
差が出たのは「登録に失敗しました」です。sonnet と Opus は高い値を出し、Jev と haiku は迷いました。この文が出る場合は、渡した前の調べに書かれていません。よくあるエラーの文の形から、調べないと原因が分からないと推し量れたかどうかの差だと見ています。Jev の 0.44 は、しきい値を 0.3 にすれば調べに回りますが、0.5 にすると省いてしまいます。
同じ材料を渡した Opus でも、精度 (AUC) は 0.78 でした。sonnet との差は揺れの幅の中です。渡した材料に無いことは、賢いモデルに替えても埋まりません。一方で、Jev と sonnet・Opus の差は、揺れの幅を超えていました。Jev は haiku と同じくらいで、渡した材料から一般の知識で推し量る判断が弱いと考えています。
実際に会話に入れてみた
「Jev の値がしきい値より低いターンだけ、調べを省く」形で、評価用の会話を流しました。
しきい値 0.3
しきい値 0.5
正解と突き合わせると、要った調べをあまり落とさずに省けるのは、2 ターン目以降の 1〜2 割まででした。評価で返事を大きく速くできたのは、Jev ではなく、前のターンで調べた結果を短い答えのまま次のターンへ渡す案でした (返事 1 回 38 秒 → 28 秒)。ただ、会話を 128 件ずつに増やして品質を測ると、拾えた事実の割合が 3.3 ポイント下がる傾向が出ました。コードを調べる役を軽いモデル (haiku) に替える案は、調べの費用が約 13 分の 1 になったものの、返事の速さはほとんど変わらず、コードを深く読む場面で結論の正しさが落ちる傾向が出ました。品質を先にしたいので、2 つとも本番には入れていません。
まとめ
- 判定そのものは速くて安い。1 回約 0.3 秒で、費用は 1 回約 0.00006 ドル
- 要った調べをあまり落とさずに省けるのは、2 ターン目以降の 1〜2 割まで。それで回答の質が保てるかは、確かめきれていない
- 確かめるだけの発言は、Jev も含めてどの判定役も見分けられた
- 前の調べで足りるかを推し量る判断は、Jev は haiku と同じくらいで、sonnet・Opus よりはっきり弱い
- Opus でも 0.78 で、賢いモデルに替えるだけでは上がりきらない。次に試すなら、システムの画面や作りの説明を判定役に渡したときに、見分けられるようになるか
現状の検証結果
- 1 つの業務の、1 つの判断 (コードを調べるか) だけを見た小さな検証です。181 ターンです
- 判定役に渡したのは、直前の会話と前の調べの結果だけです (「やり方」の「判定役に渡したもの」)。システムの説明を足したときにどう変わるかは、試していません
- 試したのは、評価で AI が演じたお客様役の会話だけです。本番の会話には入れていません
- 正解は 1 つの AI (Claude Opus 5) だけが付け、ほかの AI や人が付けた正解とは付け合わせていません。人が付けた正解とは違う可能性があります
- Jev への聞き方を 5 通り試すと、よいものの平均で 0.69 まで上がりました。ただし同じ 181 ターンで選んだ数字なので、上の比較には使っていません
- 同じターンを引き直して計算すると、Opus と sonnet の差 (0.024) は揺れの幅の中でした。Jev と sonnet の差 (約 0.14) は、揺れの幅を超えていました
- Jev を入れた会話の評価は 1 案あたり 16〜48 会話です。この数では、回答の質が数ポイント下がっても見分けられません。会話の評価の採点も AI が行いました (Jev の評価は Claude Opus 5、haiku と前の調べを渡す案の比べは Claude Opus 5.5)